dsh-vision-resident
by AnnanRen
常驻视觉子代理插件:自动转译粘贴的图片,提供 describe_image 工具,以及按会话隔离的对话记忆、状态胶囊和详情页(DeepSeek Harness)。
常驻视觉子代理插件:粘贴图片自动转译、describe_image 工具、按会话隔离的对话记忆与状态胶囊+详情页(DeepSeek Harness)
安装
dsh plugin --profile web add github:AnnanRen/dsh-vision-residentGitHub 源码安装:首次需按提示配置 allowBuilds 构建授权后重试
安装与环境配置指引、插件开发教程见 DSH 中文社区文档 ↗
安装即在你的机器上以你的权限运行第三方代码——它可读写文件、使用凭据、访问网络,DSH 的工具审批不会为插件代码加沙箱。「检测到 manifest」仅代表发现 dsh.bundle / dsh.plugin 清单,不构成兼容性或安全审查;安装前请审阅源码,不熟悉的插件先在不含密钥的环境试用。
README
DeepSeek Harness 的常驻视觉子代理插件:一个住在宿主进程里的视觉助手,让纯文本主模型(如 DeepSeek)也能"看"图——粘贴图片自动转译、随时调用识别/验收、像对话一样记住上下文。
- 零子代理开销:视觉模型直连(
ctx.llm.stream),每次识别只是一次 LLM 推理,没有 agent 上下文初始化成本 - 常驻对话:视觉子代理有自己的持续上下文(记住看过的图与识别结果),追问不重发图片
- 按会话隔离:每个 DSH 对话拥有独立的视觉历史、上下文与计数,互不串扰
- 跨重启持久化:识别历史与转译缓存落盘,重启不丢、不重复转译
- 归档联动:主会话归档后,对应视觉记录自动清除
截图
输入框常驻胶囊
平时是一个融入输入框工具行的小胶囊,实时显示视觉子代理状态(工作中/空闲)、模型名称、本对话识别次数;点击打开详情页:
子代理详情页(折叠式对话史)
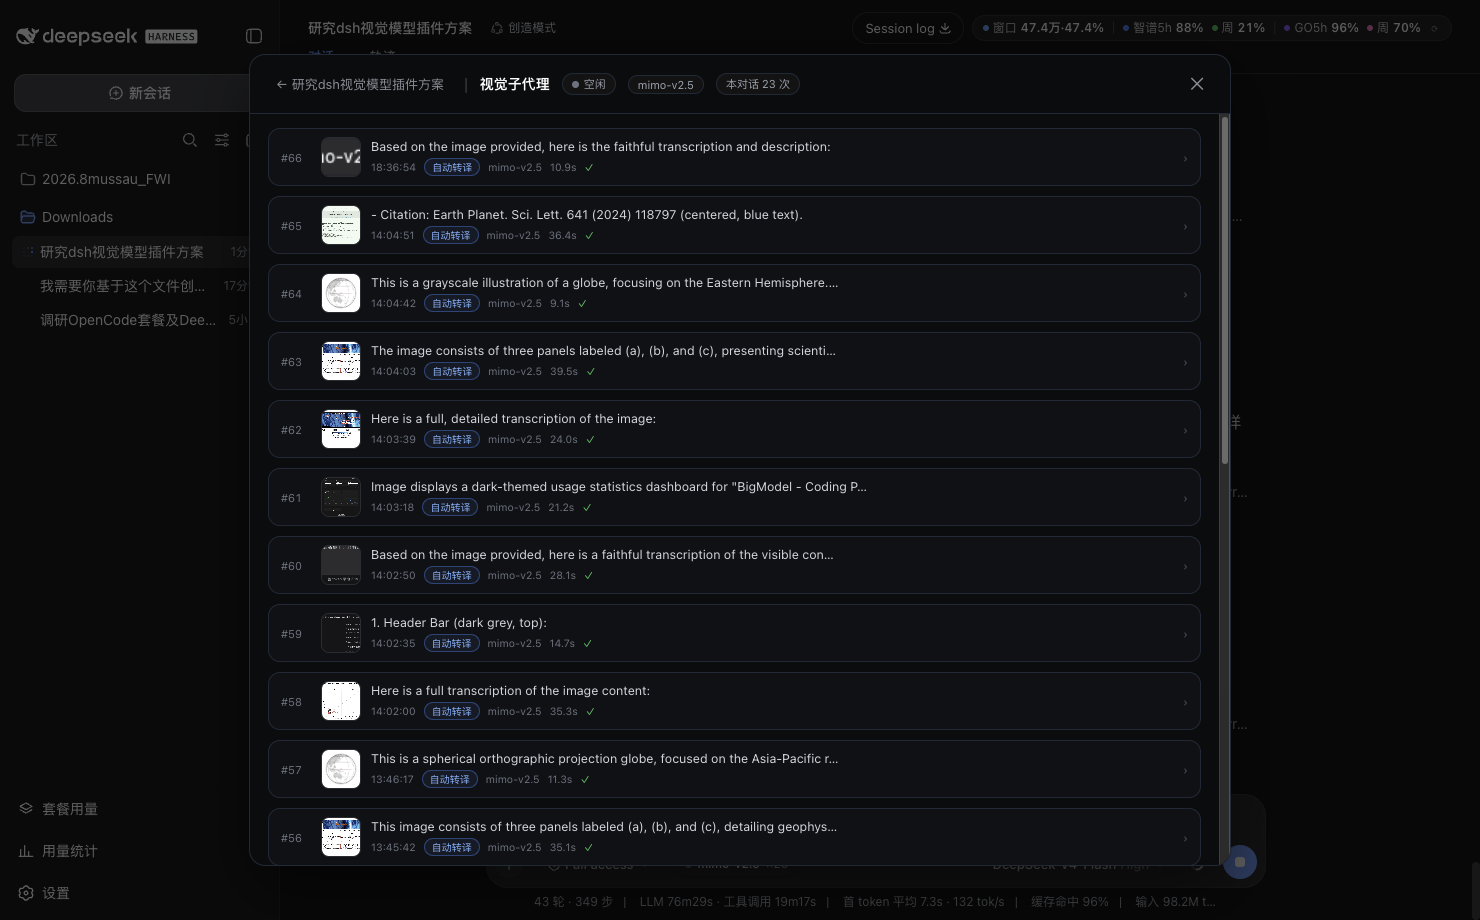
每张图一次识别 = 一条折叠条目:序号 + 图片缩略图 + 一句话概况;点击展开看完整识别过程(指令 / 思考过程 / 输出)。头部有「← 返回主对话」,Esc / 点背景关闭:
功能
describe_image/subagent_vision工具:读磁盘图片 → 视觉模型 → 文字结果。用于截图验收 / UI 审查 / OCR / 看图问答。省略image_path即可纯文字追问——基于视觉子代理自己看过的图直接回答。- 粘贴图片自动转译(
llm/stream钩子):聊天里粘贴图片照常显示;发送时若当前模型不支持图片,自动调视觉模型转成文字注入请求(描述不进会话、不显示);模型本身支持图片则原样透传。read_image等工具放在tool-result.content里的内嵌图片也会被正确转译。 - 常驻会话记忆:按 DSH 对话隔离,最近 10 轮识别(指令 + 结果文字)作为上下文,追问不重发整图、不重复识别。
- 状态胶囊 + 详情页:输入框左端小胶囊 + 全屏折叠式对话史(序号 / 缩略图 / 概况 / 展开详情)。
- 生命周期管理:会话上限 40(LRU)、闲置 30 天清理、主会话归档 30 秒内清除对应记录。
安装
# 方式一:clone 到本地后挂进 profile
git clone https://github.com/AnnanRen/dsh-vision-resident.git
ln -s "$PWD/dsh-vision-resident" ~/.dsh/profiles/node_modules/dsh-vision-resident
# 在 ~/.dsh/profiles/web/cordis.patch.yml 的 insert 列表加:
#   - id: dsh-vision-resident
#     name: dsh-vision-resident
# 重启 dsh web
配置
视觉模型
默认使用 opencode-go/mimo-v2.5(主)与 opencode-go/minimax-m3(回退),同一供应商。可用环境变量覆盖:
export VISION_PROVIDER=opencode-go          # 视觉模型 provider
export VISION_MODEL=mimo-v2.5               # 视觉模型 id
export VISION_FALLBACK_MODELS=opencode-go/minimax-m3  # 回退链(逗号分隔)
粘贴准入(纯文本主模型)
Harness 在 API 代理层按选中模型的 input 声明做图片准入检查。要让纯文本主模型(如 deepseek-v4-flash)能粘贴图片,需在 ~/.dsh/settings.yaml 里给它声明 input: [text, image];它真实端点是纯文本的,本插件会强制转译(deepseek-v4-flash / deepseek-v4-pro 内置在 force-convert 名单,可用 AUTO_VISION_FORCE_MODELS 追加),原图绝不直送上游。
已知限制
- 会话里已有图片时切换到不支持图片的模型会被 Harness 拒绝(
model-unavailable,安全特性)——需要切换请开新会话。 - 当前提示词带图时工具会被剥掉(避免弱模型反射性搜文件),"看图 + 同时用工具"分两步即可。
- 历史上下文只带文字(不带历史图片):实测多图请求在部分端点上不稳定,且历史识别结果已是完整文字描述,足够支撑追问。
许可证
原始 README: https://github.com/AnnanRen/dsh-vision-resident/blob/main/README.md ↗
同类插件
查看全部 →
modlens
为纯文本模型架起视觉桥梁:粘贴图片,输出结构化 JSON 证据(OCR、版面、语义)。

dsh-vision-toolkit
让纯文本模型更好地做视觉任务:带意图的图片问答、长截图 OCR、UI 还原等。

dsh-vision-router
为纯文本 Agent 提供视觉能力:内置免 Key 视觉链 + 像素级视觉工具(看图问答、定位、裁剪、像素对比、取色、OCR、矢量化、抠图、截图);粘贴图片即可用。

dsh-vision-complete
给 DeepSeek 补上「眼睛和耳朵」的多模态视觉插件:看图 / OCR / 物体检测 / 视频理解 / 语音转写 / 截图直读,一键安装(DSH 插件)。

dsh-media-skills
面向纯文本模型的免费视觉桥与生图:粘贴读图、GLM-4V-Flash 与 Gemini 引擎故障转移、modlens 同款结构化证据输出,并自动播种免费视觉模型路由。

dsh-vision-opencode
给纯文本主模型加可配置识图模型:vision_read_image 工具、输入框识图模型选择器,以及纯文本路由的图片自动转文字。