dsh-visual-plugin
by jyh20030112
给纯文本模型装上眼睛:把用户图片转发给任意 OpenAI 兼容的视觉模型生成描述,并在 Web UI 右侧面板展示结果。
Gives text-only models vision: forwards user images to an OpenAI-compatible vision model and shows the descriptions in a Web UI right panel.
安装
dsh plugin --profile web add github:jyh20030112/dsh-visual-pluginGitHub 源码安装:首次需按提示配置 allowBuilds 构建授权后重试
安装与环境配置指引、插件开发教程见 DSH 中文社区文档 ↗
安装即在你的机器上以你的权限运行第三方代码——它可读写文件、使用凭据、访问网络,DSH 的工具审批不会为插件代码加沙箱。「检测到 manifest」仅代表发现 dsh.bundle / dsh.plugin 清单,不构成兼容性或安全审查;安装前请审阅源码,不熟悉的插件先在不含密钥的环境试用。
预览截图
README
DeepSeek Harness 插件。
特性
- 自动描述图片 —— 包装适配器递归处理上传图片及工具结果中的图片,只在发给模型的副本中生成
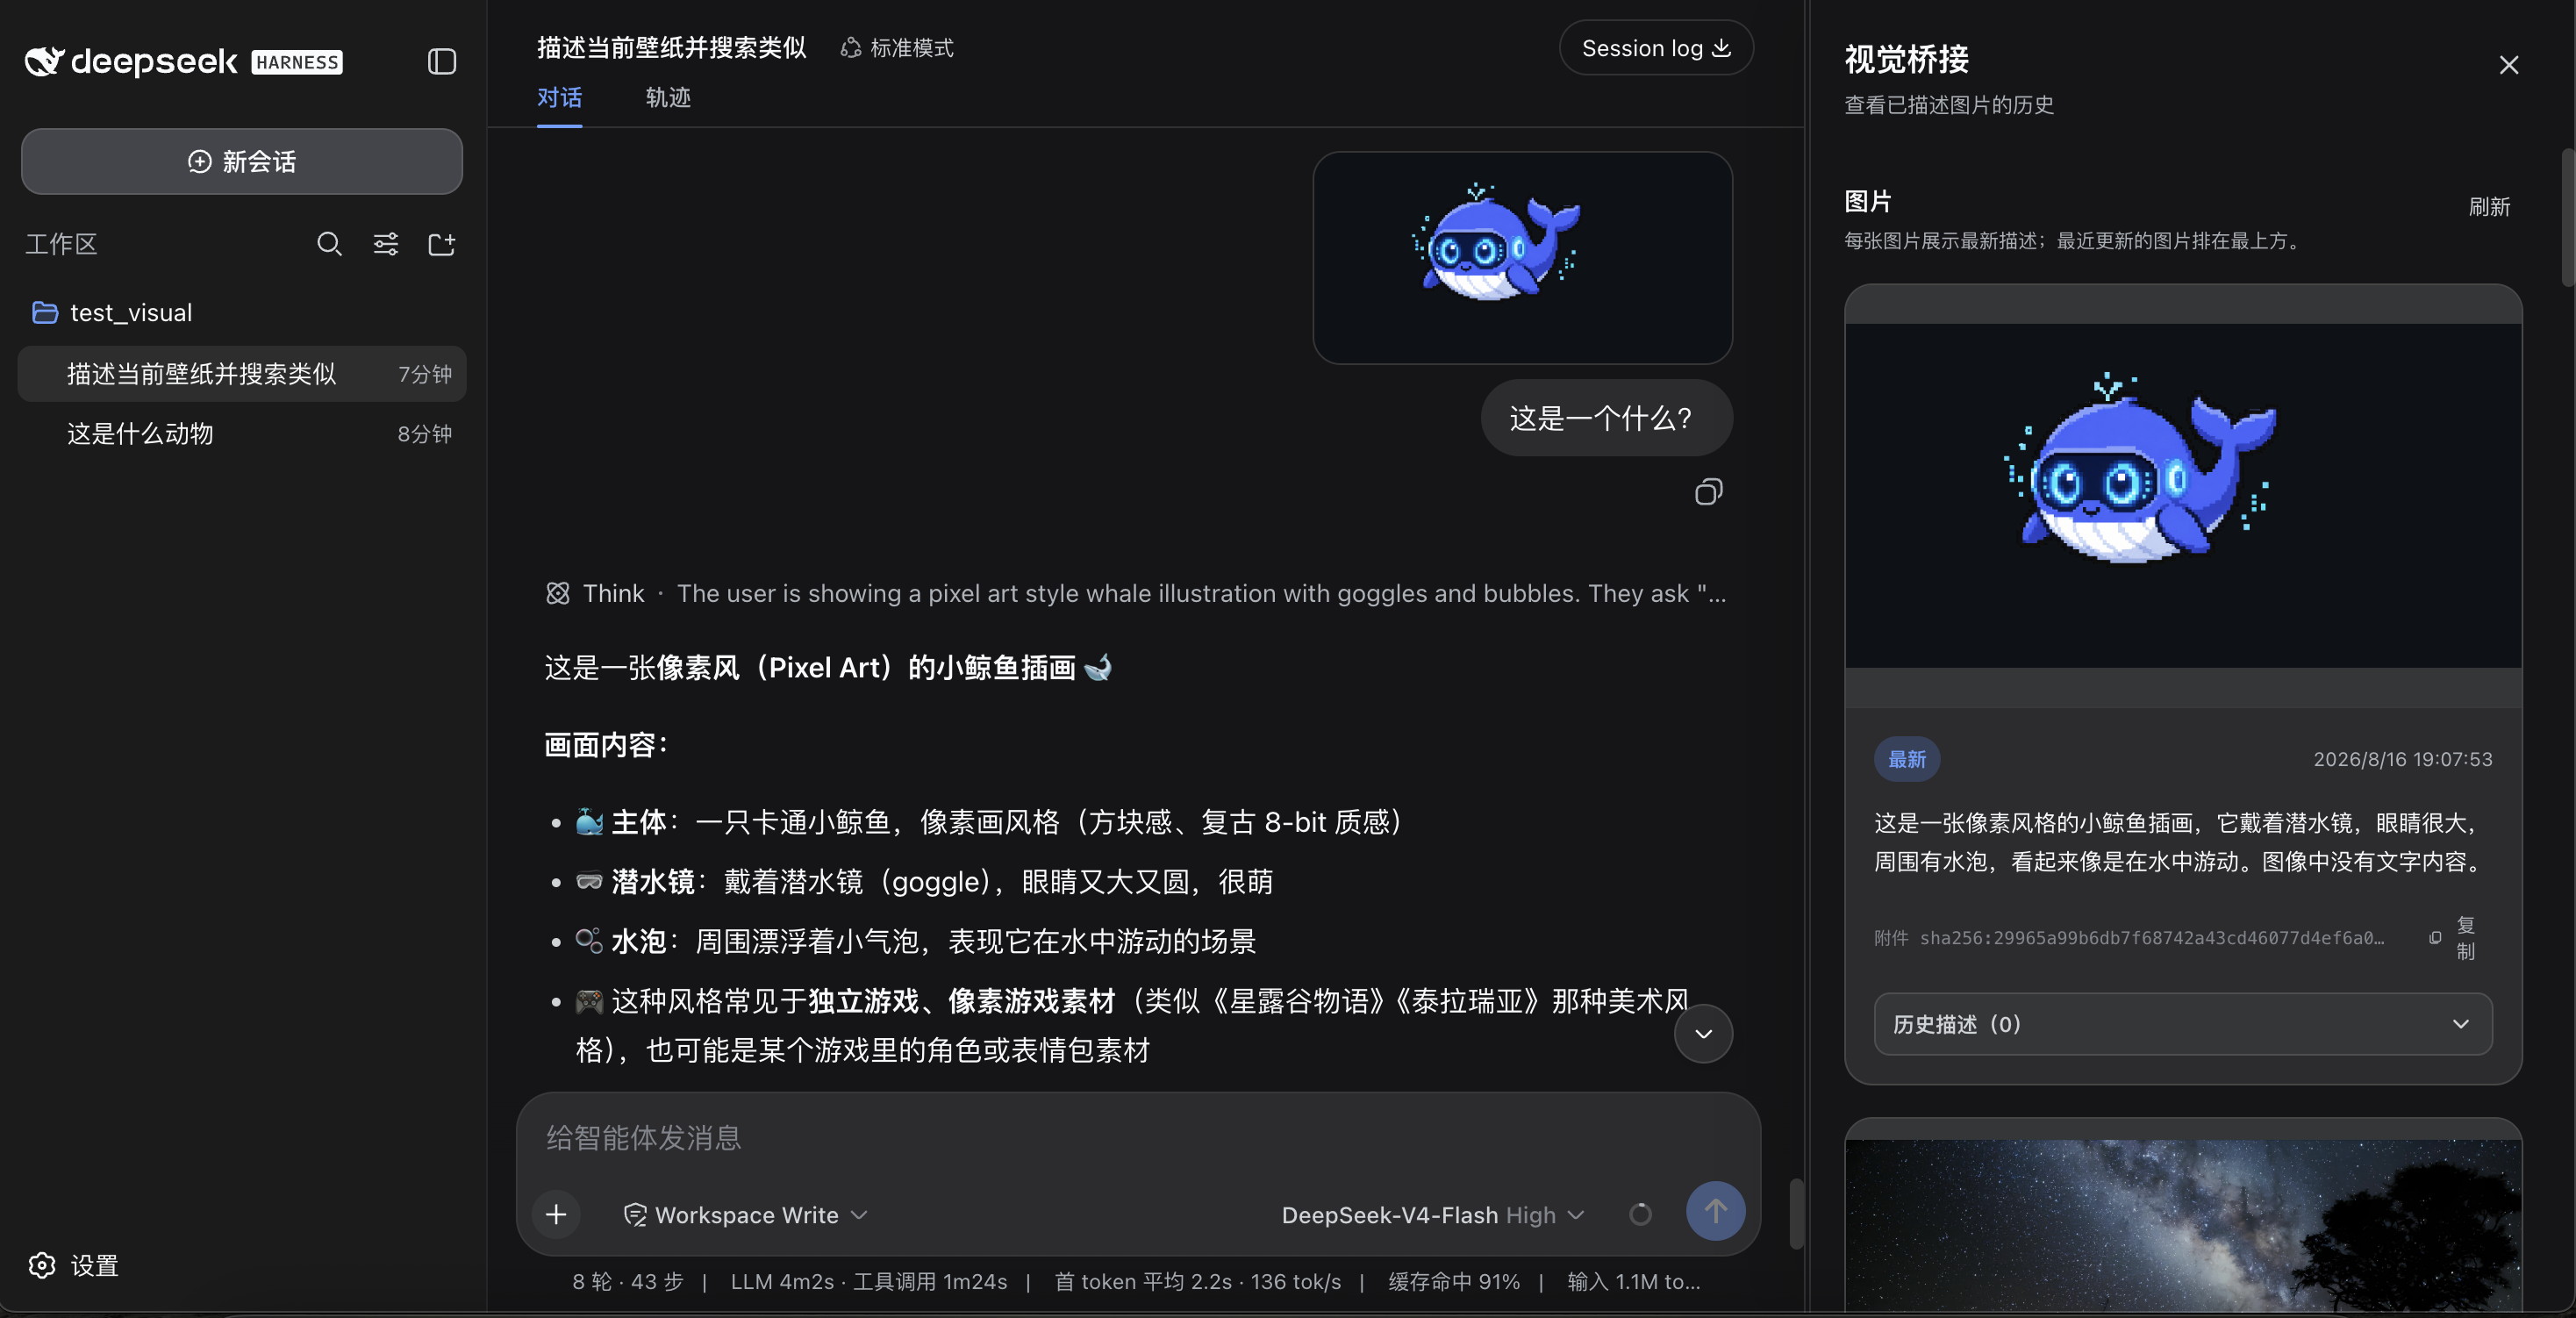
[视觉描述],聊天界面保留原内容。 - 对话内状态卡片 —— 自动解析开始后立即在原图片下方显示“正在解析”,成功或失败后原位更新;同一逻辑解析只显示一张卡片。
- 按问题定向描述 —— 发图同时带问题时,描述提示词由你的原话生成。
vision_describe工具 —— 模型可对任意已附图追问细节。- 插件自有视频上传 —— 支持 MP4、M4V、MOV、AVI、MPG/MPEG、MKV 和 WebM;扩展名、文件签名与 FFprobe 结果必须一致。
- 视频场景解析 —— 统一转为 H.264/yuv420p MP4,通过 PySceneDetect 提取关键帧,再由视觉模型提供时间戳证据、当前 DSH 文本模型完成回答。
- 右侧面板 —— 在图片/视频卡片间切换,直接播放视频、选择视频到会话草稿,并查看依赖健康状态。
- 密钥不落地 —— API Key 经 harness credentials 缝存储(只写不回显)。
工作原理
输入栏或工具结果产生图片 → 包装适配器递归发现 → 聊天记录保留原始图片
  → adapter stream → readImage → 视觉 API → 仅在模型私有请求中改写为 "[视觉描述] …"
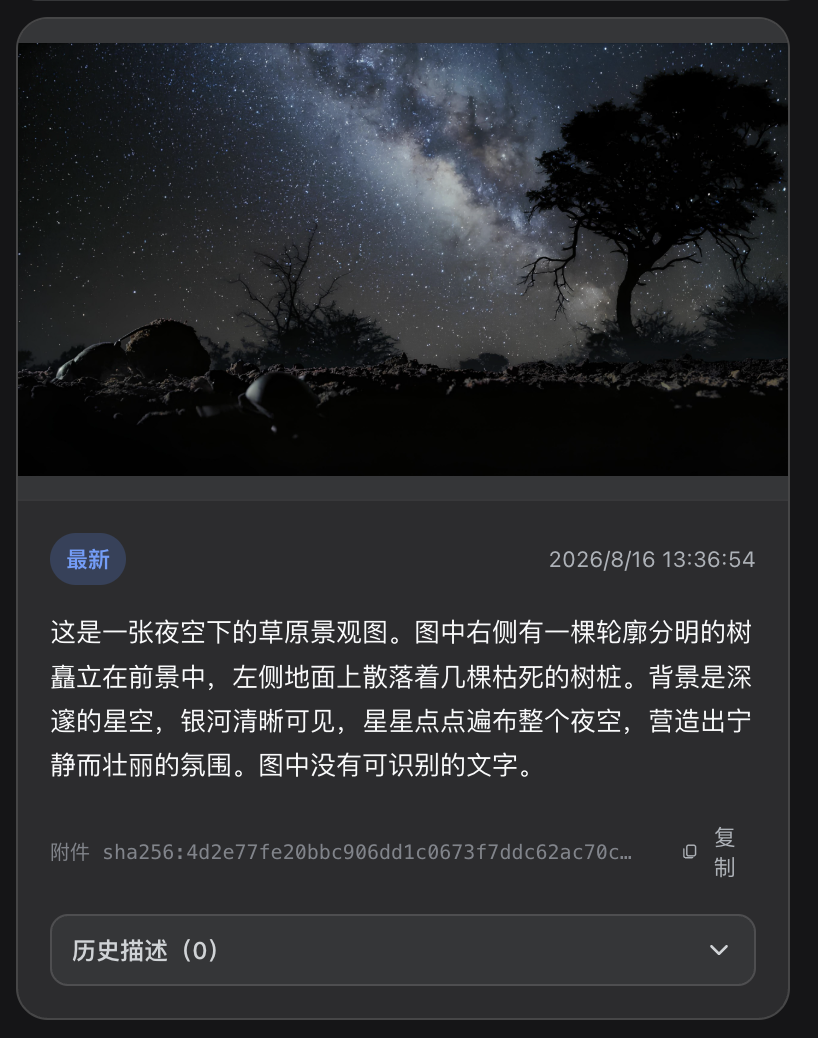
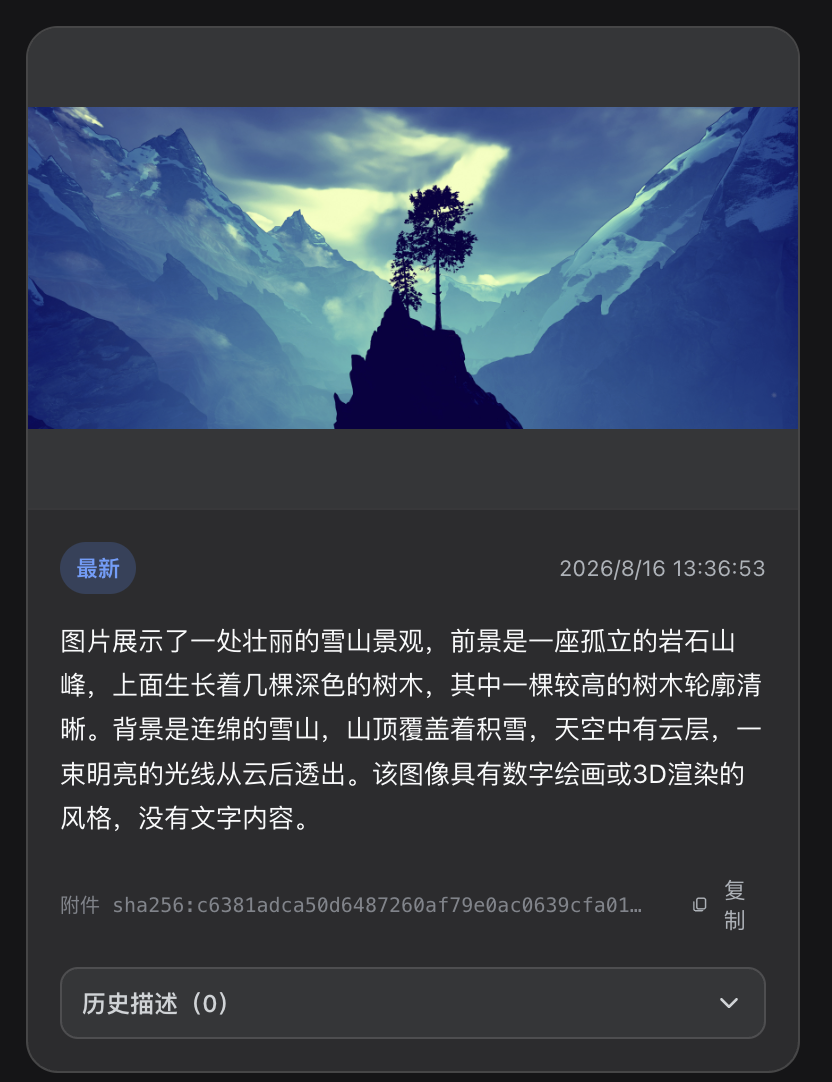
  → 纯文本模型作答 → /vision-bridge/recent → 面板缩略图 + 描述(2s 轮询)
未配置或调用失败时降级为 [视觉描述失败] <原因> 占位文本,对话不会中断。
快速开始
视频功能需要宿主机预先安装 FFmpeg/FFprobe >= 6.1(同一主版本,含 libx264)和 PySceneDetect >= 0.7.1 < 0.8:
ffmpeg -version
ffprobe -version
python -m pip install 'scenedetect[opencv]>=0.7.1,<0.8'
scenedetect version
插件不会自动下载或执行安装脚本。缺少依赖时图片功能仍可用,设置页会列出视频依赖问题。
dsh plugin --profile web add dsh-visual-plugin # 或:github:jyh20030112/dsh-visual-plugin
若使用本地 DeepSeek Harness 源码开发,请改为链接本地插件目录:
cd /absolute/path/to/dsh-visual-plugin
npm run bootstrap
dsh plugin --profile web add link:/absolute/path/to/dsh-visual-plugin
bootstrap 会自动查找同级或祖先目录旁的 Harness 检出。其他布局请显式指定:
HARNESS=/absolute/path/to/deepseek-harness npm run bootstrap
重启 dsh web 后:
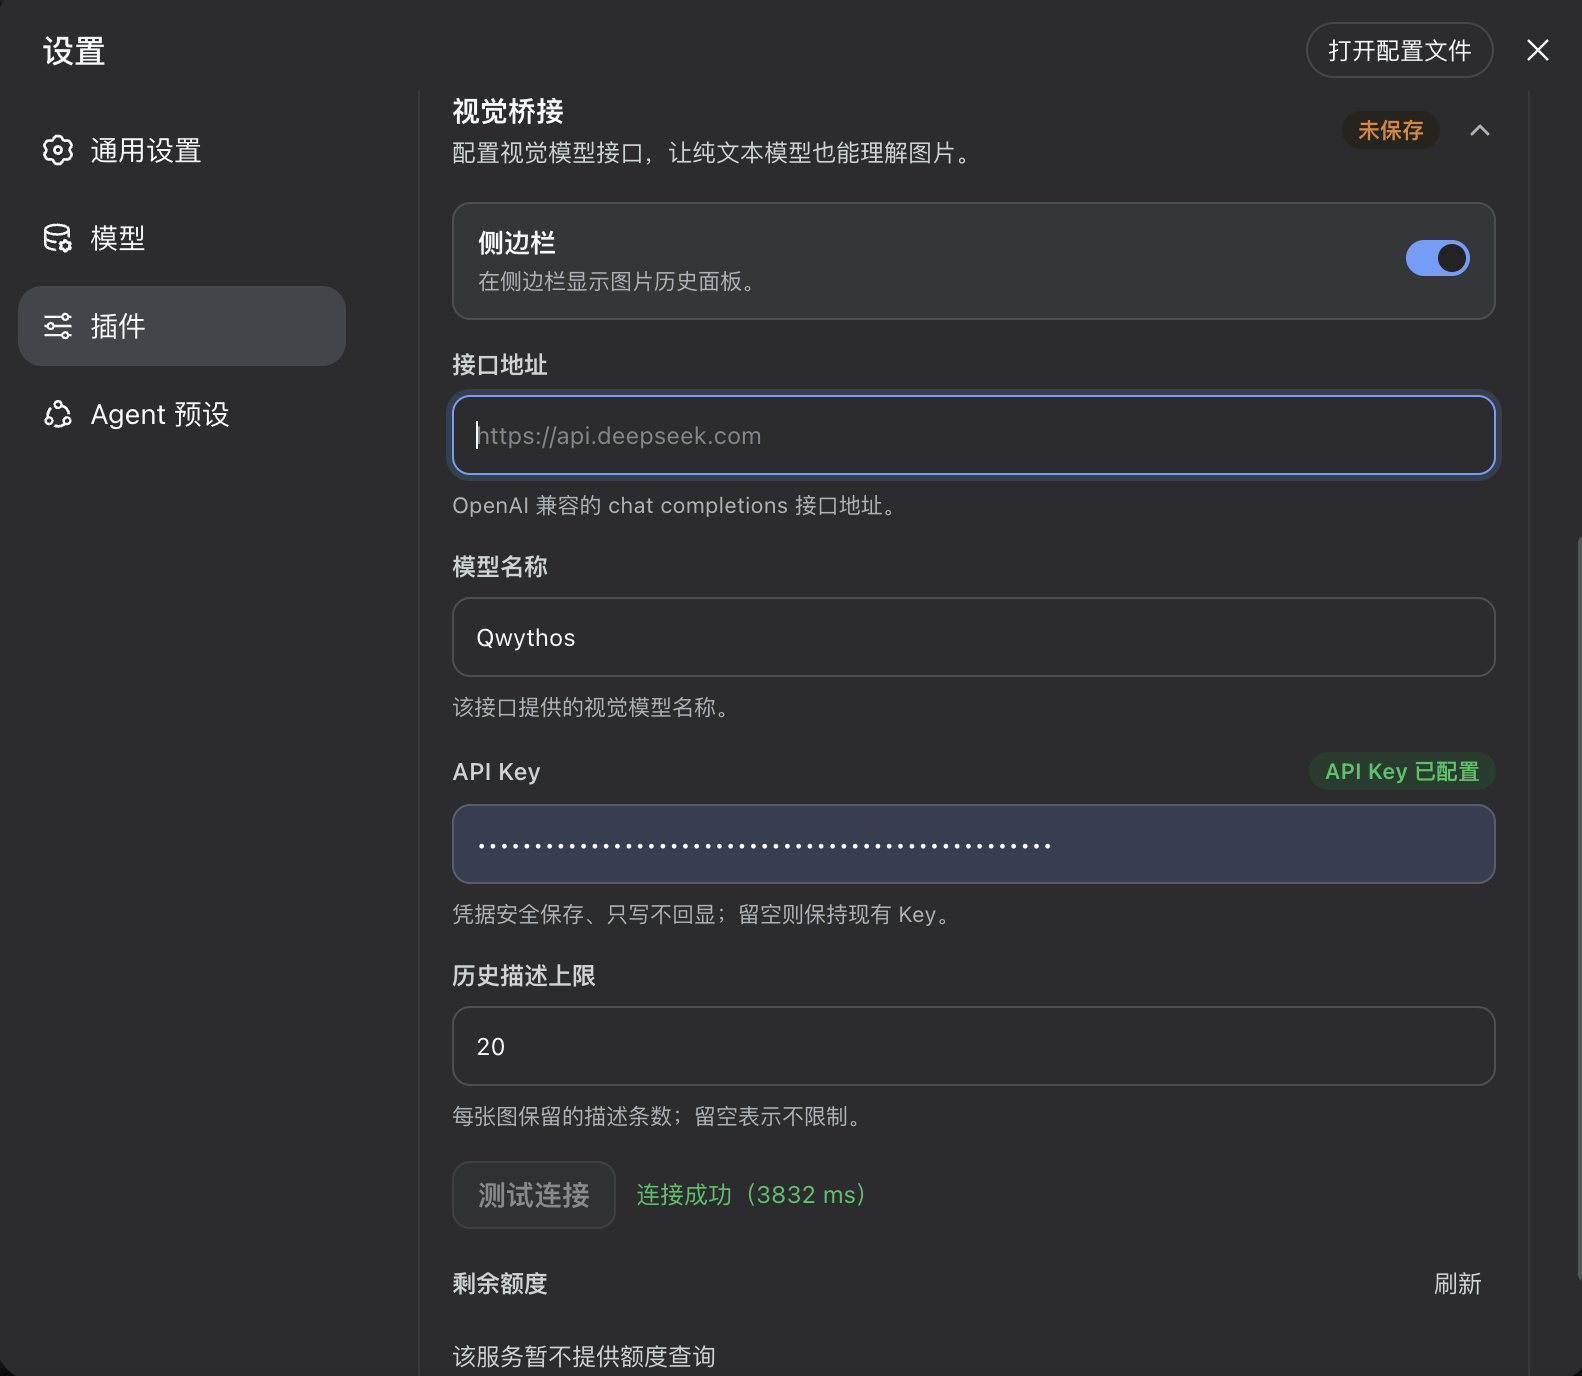
打开 设置 → 插件 → 插件配置,展开 视觉桥接 卡片:
填写接口地址、视觉模型名、API Key。侧边栏 开关控制图片历史面板的显示/隐藏;历史描述上限默认 20,留空表示不限制。点 保存,再 测试连接。
在模型选择器中选 DeepSeek (Vision) —— 插件的包装适配器声明支持图片输入,网关才会放行上传。
发送一张图片(可附带问题)。主模型基于生成的描述作答,图片历史面板约 2 秒内出现缩略图 + 描述。
视频可从输入框旁的视频按钮上传。处理完成后在右侧选择 视频 播放;点击 在会话中提问 只会写入草稿,确认后再发送。
参考本地模型
本项目目前使用本地部署的
Empero AI Qwythos-9B
作为视觉后端进行开发和验证。该模型可通过 SGLang 提供 OpenAI 兼容的
/v1 接口;在视觉桥接面板中填写接口地址和服务端注册的模型名称
(例如 Qwythos)即可。插件并不绑定 Qwythos-9B,也可以接入其他兼容的视觉模型。
卸载
dsh plugin --profile web remove dsh-visual-plugin
重启 dsh web。该命令会在 profile 内转发执行 pnpm remove,bundle 层列表会自动同步移除该插件。
项目结构
src/
  index.ts      host 插件:视觉编排 + vision_describe + HTTP 路由
  vision.ts     OpenAI 兼容视觉调用(describe / test / balance)
  model-messages.ts  模型请求边界改写 + 按附件缓存
  description-policy.ts  意图优先提示词 + 低信息重试
  config.ts     settings 命名空间 `vision-bridge` + schema
  adapter.ts    deepseek-vision 包装适配器(图片入站 + 私有改写边界)
  video/        上传、容器探测、转码、场景检测、关键帧解释与 HTTP Range 播放
  client/       浏览器半:面板 / 侧栏开关 / 自动解析与工具卡片 / 文案 / 样式
cordis.patch.yml  bundle 补丁层
构建
npm run bootstrap && npm run typecheck && npm run build # 需要本地 harness 检出
预构建 lib/ 已提交,使用者无需构建。
CI/CD
ci.yml 在每次 push/PR 校验产物与打包内容;release.yml(tag v*)校验版本、打包、创建 GitHub Release 并发布到 npm。
相关资源
- DeepSeek Harness —— 本插件所扩展的宿主框架。
- Hugging Face 上的 Qwythos-9B —— 开发与测试所用的本地视觉模型。
- —— 收录本插件的 DSH 插件精选列表。
致谢
- HsiangNianian — 感谢开发过程中的帮助与建议。
- tingfeng347 — 感谢构建稳定性修复与本地 harness 开发环境的完善。
- dsh-auto-continue — 网络错误等异常导致请求被中断时自动发送「继续」恢复的 DSH 插件(错误分类、自适应退避、浏览器通知),很好用的搭配。
许可证
原始 README: https://github.com/jyh20030112/dsh-visual-plugin/blob/main/README.zh.md ↗
同类插件
查看全部 →
modlens
为纯文本模型架起视觉桥梁:粘贴图片,输出结构化 JSON 证据(OCR、版面、语义)。

dsh-vision-toolkit
让纯文本模型更好地做视觉任务:带意图的图片问答、长截图 OCR、UI 还原等。

dsh-vision-router
为纯文本 Agent 提供视觉能力:内置免 Key 视觉链 + 像素级视觉工具(看图问答、定位、裁剪、像素对比、取色、OCR、矢量化、抠图、截图);粘贴图片即可用。

dsh-vision-complete
给 DeepSeek 补上「眼睛和耳朵」的多模态视觉插件:看图 / OCR / 物体检测 / 视频理解 / 语音转写 / 截图直读,一键安装(DSH 插件)。

dsh-media-skills
面向纯文本模型的免费视觉桥与生图:粘贴读图、GLM-4V-Flash 与 Gemini 引擎故障转移、modlens 同款结构化证据输出,并自动播种免费视觉模型路由。

dsh-vision-opencode
给纯文本主模型加可配置识图模型:vision_read_image 工具、输入框识图模型选择器,以及纯文本路由的图片自动转文字。